Domain intelligente-stromnetze.de kaufen?
Wir ziehen mit dem Projekt
intelligente-stromnetze.de um.
Sind Sie am Kauf der Domain
intelligente-stromnetze.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain intelligente-stromnetze.de kaufen?
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
Wie kann Data Visualization dabei helfen, komplexe Daten verständlich und ansprechend darzustellen?
Data Visualization kann komplexe Daten in visuell ansprechende Grafiken und Diagramme umwandeln, die leichter zu verstehen sind als reine Zahlen. Durch die Verwendung von Farben, Formen und anderen visuellen Elementen können Muster und Trends in den Daten schnell erkannt werden. Dies ermöglicht es Entscheidungsträgern, fundierte Entscheidungen auf der Grundlage der präsentierten Informationen zu treffen. **
Ähnliche Suchbegriffe für Daten Data
Top-Angebote
Produkte zum Begriff Daten Data:
-
SBS USB Data Cable Apple Lightning C-89 1m black Kabel Digital/Daten 1 m (TECABLEUSBIP589K)Typ: Kabel, Einsatzbereich: Digital / Daten, Kabellänge: 1m, Universelle Schnittstellen: USB 2.0, Farbe: Schwarz, Video/AV und Netzwerkanschlüsse: USB Typ A19,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data Grid ELS ProgramRed Hat Data Grid ELS Program – erweiterter Lifecycle-Support für bestehende Data-Grid-Umgebungen Ein professionelles Red Hat Supportprogramm für Unternehmen, die vorhandene Red Hat Data Grid Umgebungen während einer Übergangs-, Stabilitäts- oder Migrationsphase strukturiert weiterführen möchten. Red Hat Data Grid ELS Program ist ein professionelles Red Hat Extended-Life-Cycle-Support-Programm für Unternehmen, die bestehende Red Hat Data Grid Umgebungen über den regulären Wartungszeitraum hinaus planbar weiterführen möchten. Der Fokus liegt nicht auf der Einführung neuer Produktfunktionen, sondern auf einem erweiterten Supportrahmen für vorhandene Data-Grid-, Caching- und In-Memory-Datenumgebungen, die aus technischen, organisatorischen oder projektbezogenen Gründen noch nicht sofort modernisiert oder migriert werden können. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Support- beziehungsweise Subskriptionsgrundlage für den vorgesehenen Einsatzbereich. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, Application Services, Integration, OpenShift, Linux oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der Laufzeit und der vorgesehenen Einsatzumgebung. Das Programm eignet sich für IT-Abteilungen, Plattformteams, Middleware-Verantwortliche, Anwendungsarchitekten und Organisationen, die Red Hat Data Grid weiterhin in produktiven oder geschäftsnahen Szenarien einsetzen. In gewachsenen IT-Landschaften sind Data-Grid-Umgebungen häufig eng mit Anwendungen, Backend-Systemen, Authentifizierungsdiensten, Datenflüssen, Caching-Prozessen und internen Geschäftsabläufen verbunden. Das ELS Program unterstützt Unternehmen dabei, den Weiterbetrieb solcher Umgebungen klar zu planen und notwendige Übergangsphasen kontrolliert zu gestalten. Programm für vorhandene Red Hat Data Grid Installationen Das Red Hat Data Grid ELS Program ist für Unternehmen gedacht, die bestehende Data-Grid-Umgebungen nicht kurzfristig ablösen können und dafür einen erweiterten Supportrahmen benötigen. Das betrifft insbesondere In-Memory-Datenplattformen, Caching-Strukturen und verteilte Datenumgebungen, die mit Anwendungen, Plattformdiensten, Backend-Systemen oder geschäftskritischen Prozessen verbunden sind. Durch die zusätzliche ELS-Abdeckung erhalten Organisationen mehr Zeit, um Migrationen, Modernisierungsprojekte oder Architekturentscheidungen sauber vorzubereiten. Bestehende Data-Grid-Prozesse lassen sich strukturiert weiterführen, während parallel eine langfristige Zielplattform, ein aktualisierter Architekturansatz oder ein geordneter Wechsel auf unterstützte Produktversionen geplant wird. Für Übergangsphasen, Stabilität und Migrationsplanung Das ELS Program passt zu Unternehmen, die Red Hat Data Grid weiterhin einsetzen und gleichzeitig den späteren Wechsel auf eine aktuelle Data-Grid-, Middleware- oder Plattformumgebung vorbereiten. In vielen produktiven Umgebungen ist eine sofortige Ablösung nicht realistisch, weil Anwendungen angepasst, Abhängigkeiten geprüft, Betriebsprozesse dokumentiert und Fachbereiche eingebunden werden müssen. Ein klar definierter ELS-Rahmen hilft dabei, diese Phase professionell zu organisieren. Der konkrete Einsatz sollte anhand der vorhandenen Data-Grid-Umgebung, der bestehenden Red Hat Subskription, der eingesetzten Plattform, der Supportanforderungen und der geplanten Migrationsstrategie bewertet werden. Besonders bei produktiven Daten- und Caching-Umgebungen ist es sinnvoll, Betriebsrisiken, Kompatibilität, Projektlaufzeiten und langfristige Plattformplanung gemeinsam zu betrachten. So lässt sich das Programm sauber in IT-, Einkaufs- und Budgetprozesse einordnen. Geeignet für geschäftskritische Data-Grid-Landschaften Red Hat Data Grid wird in vielen Unternehmen für verteilte Daten-, Caching- und Performance-nahe Anwendungsszenarien eingesetzt. Wenn solche Umgebungen weiterhin benötigt werden, bietet das ELS Program eine strukturierte Grundlage, um den bestehenden Betrieb während einer begrenzten Übergangsphase besser zu planen. Das Programm eignet sich besonders für Organisationen, die Risiken im Zusammenhang mit älteren Data-Grid-Umgebungen reduzieren und gleichzeitig eine geordnete Modernisierung vorbereiten möchten. Anforderungen rund um Betrieb, Support, Kompatibilität, Projektplanung und Migration lassen sich dadurch gezielter in bestehende Unternehmensprozesse integrieren. ELS-Programm für planbaren Weiterbetrieb Das Red Hat Data Grid ELS Program beschreibt einen erweiterten Lifecycle-Supportrahmen für entsprechend geplante Data-Grid-, Caching- oder In-Memory-Datenumgebungen. Es eignet sich für Unternehmen, die bestehende Red Hat Data Grid Bereiche nicht sofort ablösen können und den weiteren Betrieb transparent in ...8643,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Fischer, Tin: Linke Daten, Rechte DatenLinke Daten, Rechte Daten , Warum wir nur das sehen, was wir sehen wollen , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20220402, Produktform: Leinen, Autoren: Fischer, Tin, Seitenzahl/Blattzahl: 240, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Statistiken; Gefühlte Wahrheit; Wahrheit; Fake News; Gesundheit; Gesellschaft; Grüne; Umwelt; Klima; Wirtschaft; Geld; Politik; Mario Mensch; Wirtschaftsstatistik; Statistik; Einwanderung, Fachschema: Analyse / Datenanalyse~Datenanalyse~Migration (soziologisch)~Wanderung (soziologisch)~Zuwanderung~Forschung (wirtschafts-, sozialwissenschaftlich) / Sozialforschung~Sozialforschung~Empirische Sozialforschung~Sozialforschung / Empirische Sozialforschung~Umwelt / Politik, Wirtschaft, Planung~Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Datenanalyse, allgemein~Sozialforschung und -statistik~Grüne Politik / Ökopolitik / Umweltschutz~Ökonometrie und Wirtschaftsstatistik~Wahrscheinlichkeitsrechnung und Statistik, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Migration, Einwanderung und Auswanderung, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 215, Breite: 144, Höhe: 26, Gewicht: 402, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 267813525,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
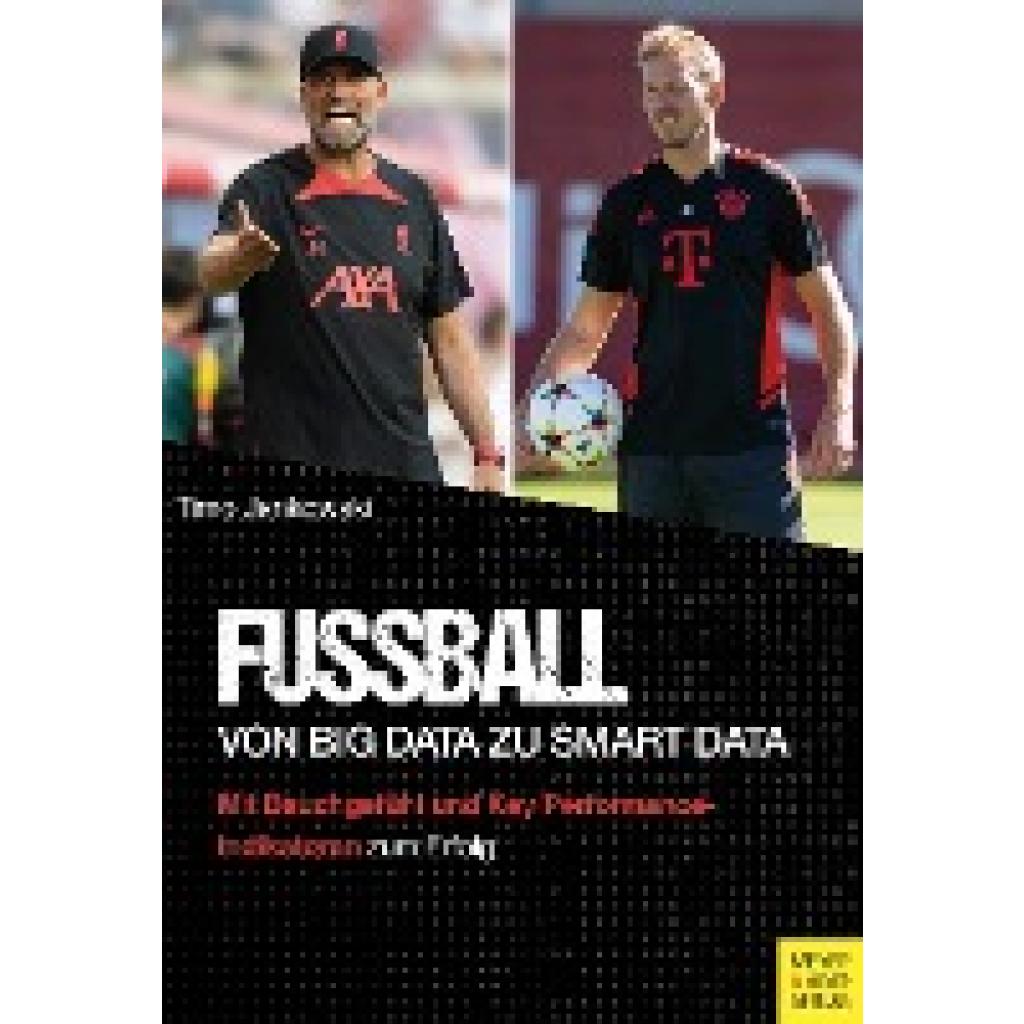
Jankowski, Timo: Fußball - Von Big Data zu Smart DataFußball - Von Big Data zu Smart Data , Das Thema Big Data ist unaufhaltsam in die Fußballwelt eingezogen und wird mit Sicherheit auch nicht mehr verschwinden. Es wird weiterhin an Bedeutung gewinnen, da die Datenqualität und die praktische Umsetzung dieser Daten bereits zahlreiche beeindruckende Erfolge vorweisen können. Zu Beginn des Buchs wird auf die Problematik des Schwarz-Weiß-Denkens, das im Fußball weit verbreitet ist, eingegangen. Im zweiten Teil rückt dann das Thema Big Data im Fußball in den Vordergrund. Dies geschieht vor allem immer im Hinblick auf die Umwandlung in Smart Data mit vielen praktischen Beispielen, sodass jeder Trainer und Interessierte zahlreiche Anregungen für die eigene Arbeit in der Planung, auf dem Platz und in der Evaluierung bekommt. Zahlreiche Key-Performance-Indikatoren (KPIs) werden unter die Lupe genommen und es wird aufgezeigt, wie Datenanalyse auf dem Weg zum Erfolg helfen kann. Ziel dieses Werks ist es, das Thema Big Data im Fußball zu entmystifizieren, weshalb im letzten Abschnitt die erfolgreiche Qualifikation der Juniorennationalmannschaft von Fidschi für die U20-Weltmeisterschaft 2023 beschrieben wird. Dieses Beispiel zeigt, wie die richtige Mischung aus objektiven Daten und den menschlichen Komponenten in der Praxis zum Erfolg führen kann. Dieses Buch plädiert dafür, die tief verwurzelten Werte und die Ursprünglichkeit des Fußballs unbedingt beizubehalten und zeigt auf, wie sich beide Seiten - Bauchgefühl und Datenanalyse - gewinnbringend miteinander verbinden lassen. Fußball - von Big Data zu Smart Data ist DAS Standardwerk für alle Trainer, die das Thema Big Data angehen wollen und Tipps für die Umsetzung auf dem Platz benötigen. , Zündkabel & Zündspulenstecker > Zünd- & Glühanlagen , Erscheinungsjahr: 20230522, Produktform: Kartoniert, Autoren: Jankowski, Timo, Seitenzahl/Blattzahl: 290, Abbildungen: ca. 100 Fotos, 60 Abbildungen, in Farbe, Keyword: aufstieg; daten im fussball; datenanalyse; fussball; leistungssteigerung; optimierung; praktische ratschläge; praxisnah; scouting; spieltag; taktik; training, Fachschema: Fußball, Warengruppe: TB/Ballsport, Fachkategorie: Fußball, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Meyer + Meyer Fachverlag, Verlag: Meyer + Meyer Fachverlag, Verlag: Meyer & Meyer Fachverlag und Buchhandel GmbH, Länge: 238, Breite: 165, Höhe: 20, Gewicht: 698, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber,28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie kann Data Visualization dabei helfen, komplexe Daten übersichtlich und verständlich darzustellen?
Data Visualization kann komplexe Daten in visuell ansprechende Grafiken und Diagramme umwandeln, die leichter zu interpretieren sind. Durch die Verwendung von Farben, Formen und Größen können Muster und Trends in den Daten schnell erkannt werden. Dadurch wird es einfacher, fundierte Entscheidungen auf Basis der Daten zu treffen. **
-
Was bedeuten Data Science und Data Engineering?
Data Science bezieht sich auf die Analyse und Interpretation von Daten, um Erkenntnisse und Muster zu gewinnen, die bei der Lösung von Problemen und der Unterstützung von Entscheidungsprozessen helfen. Data Engineering hingegen bezieht sich auf die Entwicklung und Verwaltung von Dateninfrastrukturen, um sicherzustellen, dass Daten effizient erfasst, gespeichert, verarbeitet und analysiert werden können. Data Engineering legt den Fokus auf die technische Seite der Datenverarbeitung, während Data Science sich auf die Analyse und Interpretation der Daten konzentriert. **
-
Was passiert, wenn ich bei Spotify auf "Daten löschen" bzw. "Clear Data" gehe?
Wenn du bei Spotify auf "Daten löschen" oder "Clear Data" gehst, werden alle lokal gespeicherten Daten auf deinem Gerät gelöscht. Das beinhaltet heruntergeladene Songs, Playlists und Einstellungen. Du musst dich anschließend erneut bei Spotify anmelden und deine gewünschten Einstellungen und Songs erneut herunterladen. **
-
Wie kann Data Visualization dabei helfen, komplexe Daten auf verständliche Weise zu präsentieren?
Data Visualization kann komplexe Daten visuell darstellen, um Muster und Trends leichter erkennbar zu machen. Durch die Verwendung von Diagrammen, Grafiken und interaktiven Visualisierungen können Informationen schnell und effektiv vermittelt werden. Dies erleichtert die Entscheidungsfindung und ermöglicht es, komplexe Zusammenhänge auf einen Blick zu erfassen. **
Sind "data" und "data" beim USB-Kabel TX und RX?
Nein, "data" und "data" beziehen sich nicht auf die TX (Transmit) und RX (Receive) Pins beim USB-Kabel. Beim USB-Kabel gibt es vier Pins: VCC (Stromversorgung), GND (Masse), D+ (Datenleitung) und D- (Datenleitung). Die TX- und RX-Pins werden normalerweise bei seriellen Kommunikationsschnittstellen wie UART verwendet. **
Kann man mit Wirtschaftsinformatik Data Scientist oder Data Analyst werden?
Ja, mit einem Studium der Wirtschaftsinformatik kann man sowohl Data Scientist als auch Data Analyst werden. Wirtschaftsinformatik vermittelt Kenntnisse in den Bereichen Informatik und Betriebswirtschaft, die für diese Berufe relevant sind. Zusätzliche Weiterbildungen oder Spezialisierungen in den Bereichen Data Science oder Data Analytics können jedoch von Vorteil sein. **
Top-Angebote
Produkte zum Begriff Daten Data:
-
Quantum DATA CARTRIDGE LTO-10 LTO/Ultrium Daten-Cartridge (MR-L10MQN-01)Produktbeschreibung: Quantum - LTO Ultrium 10 x 1 - 30 TB - Speichermedium, Typ: Speichermedium - LTO Ultrium, Bandkassette: Ultrium 10, Anzahl mitgelieferter Medien: 1, Farbe: Schwarz, Kapazität ohne Komprimierung: 30 TB, Kapazität mit Datenkomprimierung: 75 TB, Bandlänge: 1035 m, Kassettenetikettierung: Mit Strichcodeetikett251,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data GridRed Hat Data Grid – In-Memory-Datenspeicher für schnelle und skalierbare Anwendungen Red Hat Data Grid ist eine professionelle Red Hat Subskriptionslösung für Unternehmen, die Daten schneller bereitstellen, Anwendungen performanter machen und verteilte Datenzugriffe strukturierter organisieren möchten. Die Lösung eignet sich besonders für moderne Unternehmensanwendungen, bei denen häufig genutzte Daten mit möglichst geringer Latenz verfügbar sein sollen. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Subskription für den vorgesehenen Nutzungsumfang. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, OpenShift, Linux, Integration oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der gewünschten Laufzeit und dem konkreten Einsatzszenario. Die Lösung richtet sich an IT-Abteilungen, Entwicklungsteams, Plattformverantwortliche und Unternehmen, die datenintensive Anwendungen zuverlässiger und reaktionsschneller betreiben möchten. Red Hat Data Grid kann dabei helfen, häufig benötigte Daten näher an Anwendungen bereitzustellen und damit Zugriffe auf langsamere Backend-Systeme zu reduzieren. Dadurch eignet sich die Lösung für Szenarien, in denen Performance, Skalierbarkeit und Datenverfügbarkeit eine wichtige Rolle spielen. Schneller Zugriff auf häufig genutzte Daten Red Hat Data Grid ist für Unternehmen interessant, die ihre Anwendungen durch einen leistungsfähigen In-Memory-Datenansatz unterstützen möchten. Häufig abgefragte Daten können in geeigneten Szenarien schneller bereitgestellt werden, sodass Anwendungen reaktionsschneller arbeiten und Benutzeranfragen effizienter verarbeitet werden können. Gerade bei geschäftskritischen Anwendungen kann ein strukturierter Datenzugriff entscheidend sein. Wenn Systeme regelmäßig auf Datenbanken, Webservices oder andere Backend-Quellen zugreifen müssen, kann ein Data-Grid-Ansatz helfen, wiederkehrende Zugriffe besser zu organisieren. Unternehmen erhalten dadurch eine bessere Grundlage, um Performance-Anforderungen kontrollierter zu planen und bestehende Anwendungen gezielt zu unterstützen. Verteilte Datenhaltung für moderne Enterprise-Architekturen Red Hat Data Grid unterstützt verteilte Datenstrukturen und kann in passenden Umgebungen dazu beitragen, Daten über mehrere Knoten hinweg bereitzustellen. Dadurch eignet sich die Lösung für Unternehmen, die skalierbare Anwendungen betreiben und Datenzugriffe nicht nur lokal, sondern über moderne Plattform- und Cluster-Architekturen hinweg organisieren möchten. In wachsenden IT-Landschaften ist es wichtig, Datenzugriffe nachvollziehbar und flexibel zu gestalten. Anwendungen, Services und Plattformen müssen oft schnell auf Informationen zugreifen können, ohne dass zentrale Backend-Systeme unnötig belastet werden. Red Hat Data Grid bietet hierfür eine professionelle Grundlage, um Datenzugriffe, Caching-Strategien und verteilte Anwendungsprozesse besser miteinander zu verbinden. Für Anwendungen, Plattformen und hybride Umgebungen Red Hat Data Grid kann in unterschiedlichen Unternehmensumgebungen relevant sein. Dazu gehören klassische Java-Anwendungen, moderne Plattformarchitekturen, containerisierte Workloads oder hybride IT-Landschaften. Die genaue technische Umsetzung hängt vom jeweiligen Red Hat Subskriptionsmodell, der vorhandenen Infrastruktur und dem geplanten Einsatzbereich ab. Besonders in Verbindung mit Red Hat OpenShift und modernen Plattformstrategien kann Data Grid eine wichtige Rolle spielen, wenn Anwendungen performante Datenzugriffe benötigen. Unternehmen können damit eine zusätzliche Ebene für schnelle Datenbereitstellung, Caching und verteilte Datenprozesse einplanen, ohne ihre gesamte Anwendungsarchitektur sofort grundlegend verändern zu müssen. Mehr Struktur für Performance- und Caching-Szenarien Red Hat Data Grid eignet sich für Szenarien, in denen Daten häufig genutzt, schnell abgefragt oder über mehrere Anwendungsteile hinweg verfügbar gemacht werden sollen. Unternehmen können damit eine strukturierte Grundlage schaffen, um Caching-Strategien, Datenzugriffe und Performance-Anforderungen besser zu planen. In-Memory-Datenzugriff: Geeignet für Anwendungen, die häufig benötigte Daten besonders schnell abrufen sollen. Verteilte Datenstrukturen: Unterstützt Szenarien, in denen Daten über mehrere Knoten oder Plattformbereiche hinweg organisiert werden müssen. Performance-Optimierung: Eine passende Grundlage, um Anwendungen mit hohen Anforderungen an Reaktionszeit und Datenzugriff besser zu unterstützen. Enterprise-Integration: Kann in bestehende Anwendungs-, Middleware- und Plattformstrategien eingeordnet werden. Geeignet für datenintensive Unternehmensanwendungen Red Hat Data Grid ist besonders interessant für Unternehmen, die geschä...12964,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
SBS USB Data Cable Apple Lightning C-89 1m black Kabel Digital/Daten 1 m (TECABLEUSBIP589K)Typ: Kabel, Einsatzbereich: Digital / Daten, Kabellänge: 1m, Universelle Schnittstellen: USB 2.0, Farbe: Schwarz, Video/AV und Netzwerkanschlüsse: USB Typ A19,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data Grid ELS ProgramRed Hat Data Grid ELS Program – erweiterter Lifecycle-Support für bestehende Data-Grid-Umgebungen Ein professionelles Red Hat Supportprogramm für Unternehmen, die vorhandene Red Hat Data Grid Umgebungen während einer Übergangs-, Stabilitäts- oder Migrationsphase strukturiert weiterführen möchten. Red Hat Data Grid ELS Program ist ein professionelles Red Hat Extended-Life-Cycle-Support-Programm für Unternehmen, die bestehende Red Hat Data Grid Umgebungen über den regulären Wartungszeitraum hinaus planbar weiterführen möchten. Der Fokus liegt nicht auf der Einführung neuer Produktfunktionen, sondern auf einem erweiterten Supportrahmen für vorhandene Data-Grid-, Caching- und In-Memory-Datenumgebungen, die aus technischen, organisatorischen oder projektbezogenen Gründen noch nicht sofort modernisiert oder migriert werden können. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Support- beziehungsweise Subskriptionsgrundlage für den vorgesehenen Einsatzbereich. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, Application Services, Integration, OpenShift, Linux oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der Laufzeit und der vorgesehenen Einsatzumgebung. Das Programm eignet sich für IT-Abteilungen, Plattformteams, Middleware-Verantwortliche, Anwendungsarchitekten und Organisationen, die Red Hat Data Grid weiterhin in produktiven oder geschäftsnahen Szenarien einsetzen. In gewachsenen IT-Landschaften sind Data-Grid-Umgebungen häufig eng mit Anwendungen, Backend-Systemen, Authentifizierungsdiensten, Datenflüssen, Caching-Prozessen und internen Geschäftsabläufen verbunden. Das ELS Program unterstützt Unternehmen dabei, den Weiterbetrieb solcher Umgebungen klar zu planen und notwendige Übergangsphasen kontrolliert zu gestalten. Programm für vorhandene Red Hat Data Grid Installationen Das Red Hat Data Grid ELS Program ist für Unternehmen gedacht, die bestehende Data-Grid-Umgebungen nicht kurzfristig ablösen können und dafür einen erweiterten Supportrahmen benötigen. Das betrifft insbesondere In-Memory-Datenplattformen, Caching-Strukturen und verteilte Datenumgebungen, die mit Anwendungen, Plattformdiensten, Backend-Systemen oder geschäftskritischen Prozessen verbunden sind. Durch die zusätzliche ELS-Abdeckung erhalten Organisationen mehr Zeit, um Migrationen, Modernisierungsprojekte oder Architekturentscheidungen sauber vorzubereiten. Bestehende Data-Grid-Prozesse lassen sich strukturiert weiterführen, während parallel eine langfristige Zielplattform, ein aktualisierter Architekturansatz oder ein geordneter Wechsel auf unterstützte Produktversionen geplant wird. Für Übergangsphasen, Stabilität und Migrationsplanung Das ELS Program passt zu Unternehmen, die Red Hat Data Grid weiterhin einsetzen und gleichzeitig den späteren Wechsel auf eine aktuelle Data-Grid-, Middleware- oder Plattformumgebung vorbereiten. In vielen produktiven Umgebungen ist eine sofortige Ablösung nicht realistisch, weil Anwendungen angepasst, Abhängigkeiten geprüft, Betriebsprozesse dokumentiert und Fachbereiche eingebunden werden müssen. Ein klar definierter ELS-Rahmen hilft dabei, diese Phase professionell zu organisieren. Der konkrete Einsatz sollte anhand der vorhandenen Data-Grid-Umgebung, der bestehenden Red Hat Subskription, der eingesetzten Plattform, der Supportanforderungen und der geplanten Migrationsstrategie bewertet werden. Besonders bei produktiven Daten- und Caching-Umgebungen ist es sinnvoll, Betriebsrisiken, Kompatibilität, Projektlaufzeiten und langfristige Plattformplanung gemeinsam zu betrachten. So lässt sich das Programm sauber in IT-, Einkaufs- und Budgetprozesse einordnen. Geeignet für geschäftskritische Data-Grid-Landschaften Red Hat Data Grid wird in vielen Unternehmen für verteilte Daten-, Caching- und Performance-nahe Anwendungsszenarien eingesetzt. Wenn solche Umgebungen weiterhin benötigt werden, bietet das ELS Program eine strukturierte Grundlage, um den bestehenden Betrieb während einer begrenzten Übergangsphase besser zu planen. Das Programm eignet sich besonders für Organisationen, die Risiken im Zusammenhang mit älteren Data-Grid-Umgebungen reduzieren und gleichzeitig eine geordnete Modernisierung vorbereiten möchten. Anforderungen rund um Betrieb, Support, Kompatibilität, Projektplanung und Migration lassen sich dadurch gezielter in bestehende Unternehmensprozesse integrieren. ELS-Programm für planbaren Weiterbetrieb Das Red Hat Data Grid ELS Program beschreibt einen erweiterten Lifecycle-Supportrahmen für entsprechend geplante Data-Grid-, Caching- oder In-Memory-Datenumgebungen. Es eignet sich für Unternehmen, die bestehende Red Hat Data Grid Bereiche nicht sofort ablösen können und den weiteren Betrieb transparent in ...8643,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
-
Wie kann Data Visualization dabei helfen, komplexe Daten verständlich und ansprechend darzustellen?
Data Visualization kann komplexe Daten in visuell ansprechende Grafiken und Diagramme umwandeln, die leichter zu verstehen sind als reine Zahlen. Durch die Verwendung von Farben, Formen und anderen visuellen Elementen können Muster und Trends in den Daten schnell erkannt werden. Dies ermöglicht es Entscheidungsträgern, fundierte Entscheidungen auf der Grundlage der präsentierten Informationen zu treffen. **
-
Wie kann Data Visualization dabei helfen, komplexe Daten übersichtlich und verständlich darzustellen?
Data Visualization kann komplexe Daten in visuell ansprechende Grafiken und Diagramme umwandeln, die leichter zu interpretieren sind. Durch die Verwendung von Farben, Formen und Größen können Muster und Trends in den Daten schnell erkannt werden. Dadurch wird es einfacher, fundierte Entscheidungen auf Basis der Daten zu treffen. **
-
Was bedeuten Data Science und Data Engineering?
Data Science bezieht sich auf die Analyse und Interpretation von Daten, um Erkenntnisse und Muster zu gewinnen, die bei der Lösung von Problemen und der Unterstützung von Entscheidungsprozessen helfen. Data Engineering hingegen bezieht sich auf die Entwicklung und Verwaltung von Dateninfrastrukturen, um sicherzustellen, dass Daten effizient erfasst, gespeichert, verarbeitet und analysiert werden können. Data Engineering legt den Fokus auf die technische Seite der Datenverarbeitung, während Data Science sich auf die Analyse und Interpretation der Daten konzentriert. **
Ähnliche Suchbegriffe für Daten Data
-
Fischer, Tin: Linke Daten, Rechte DatenLinke Daten, Rechte Daten , Warum wir nur das sehen, was wir sehen wollen , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20220402, Produktform: Leinen, Autoren: Fischer, Tin, Seitenzahl/Blattzahl: 240, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Statistiken; Gefühlte Wahrheit; Wahrheit; Fake News; Gesundheit; Gesellschaft; Grüne; Umwelt; Klima; Wirtschaft; Geld; Politik; Mario Mensch; Wirtschaftsstatistik; Statistik; Einwanderung, Fachschema: Analyse / Datenanalyse~Datenanalyse~Migration (soziologisch)~Wanderung (soziologisch)~Zuwanderung~Forschung (wirtschafts-, sozialwissenschaftlich) / Sozialforschung~Sozialforschung~Empirische Sozialforschung~Sozialforschung / Empirische Sozialforschung~Umwelt / Politik, Wirtschaft, Planung~Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Datenanalyse, allgemein~Sozialforschung und -statistik~Grüne Politik / Ökopolitik / Umweltschutz~Ökonometrie und Wirtschaftsstatistik~Wahrscheinlichkeitsrechnung und Statistik, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Migration, Einwanderung und Auswanderung, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 215, Breite: 144, Höhe: 26, Gewicht: 402, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 267813525,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Jankowski, Timo: Fußball - Von Big Data zu Smart DataFußball - Von Big Data zu Smart Data , Das Thema Big Data ist unaufhaltsam in die Fußballwelt eingezogen und wird mit Sicherheit auch nicht mehr verschwinden. Es wird weiterhin an Bedeutung gewinnen, da die Datenqualität und die praktische Umsetzung dieser Daten bereits zahlreiche beeindruckende Erfolge vorweisen können. Zu Beginn des Buchs wird auf die Problematik des Schwarz-Weiß-Denkens, das im Fußball weit verbreitet ist, eingegangen. Im zweiten Teil rückt dann das Thema Big Data im Fußball in den Vordergrund. Dies geschieht vor allem immer im Hinblick auf die Umwandlung in Smart Data mit vielen praktischen Beispielen, sodass jeder Trainer und Interessierte zahlreiche Anregungen für die eigene Arbeit in der Planung, auf dem Platz und in der Evaluierung bekommt. Zahlreiche Key-Performance-Indikatoren (KPIs) werden unter die Lupe genommen und es wird aufgezeigt, wie Datenanalyse auf dem Weg zum Erfolg helfen kann. Ziel dieses Werks ist es, das Thema Big Data im Fußball zu entmystifizieren, weshalb im letzten Abschnitt die erfolgreiche Qualifikation der Juniorennationalmannschaft von Fidschi für die U20-Weltmeisterschaft 2023 beschrieben wird. Dieses Beispiel zeigt, wie die richtige Mischung aus objektiven Daten und den menschlichen Komponenten in der Praxis zum Erfolg führen kann. Dieses Buch plädiert dafür, die tief verwurzelten Werte und die Ursprünglichkeit des Fußballs unbedingt beizubehalten und zeigt auf, wie sich beide Seiten - Bauchgefühl und Datenanalyse - gewinnbringend miteinander verbinden lassen. Fußball - von Big Data zu Smart Data ist DAS Standardwerk für alle Trainer, die das Thema Big Data angehen wollen und Tipps für die Umsetzung auf dem Platz benötigen. , Zündkabel & Zündspulenstecker > Zünd- & Glühanlagen , Erscheinungsjahr: 20230522, Produktform: Kartoniert, Autoren: Jankowski, Timo, Seitenzahl/Blattzahl: 290, Abbildungen: ca. 100 Fotos, 60 Abbildungen, in Farbe, Keyword: aufstieg; daten im fussball; datenanalyse; fussball; leistungssteigerung; optimierung; praktische ratschläge; praxisnah; scouting; spieltag; taktik; training, Fachschema: Fußball, Warengruppe: TB/Ballsport, Fachkategorie: Fußball, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Meyer + Meyer Fachverlag, Verlag: Meyer + Meyer Fachverlag, Verlag: Meyer & Meyer Fachverlag und Buchhandel GmbH, Länge: 238, Breite: 165, Höhe: 20, Gewicht: 698, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber,28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data GridRed Hat Data Grid – In-Memory-Datenspeicher für schnelle und skalierbare Anwendungen Red Hat Data Grid ist eine professionelle Red Hat Subskriptionslösung für Unternehmen, die Daten schneller bereitstellen, Anwendungen performanter machen und verteilte Datenzugriffe strukturierter organisieren möchten. Die Lösung eignet sich besonders für moderne Unternehmensanwendungen, bei denen häufig genutzte Daten mit möglichst geringer Latenz verfügbar sein sollen. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Subskription für den vorgesehenen Nutzungsumfang. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, OpenShift, Linux, Integration oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der gewünschten Laufzeit und dem konkreten Einsatzszenario. Die Lösung richtet sich an IT-Abteilungen, Entwicklungsteams, Plattformverantwortliche und Unternehmen, die datenintensive Anwendungen zuverlässiger und reaktionsschneller betreiben möchten. Red Hat Data Grid kann dabei helfen, häufig benötigte Daten näher an Anwendungen bereitzustellen und damit Zugriffe auf langsamere Backend-Systeme zu reduzieren. Dadurch eignet sich die Lösung für Szenarien, in denen Performance, Skalierbarkeit und Datenverfügbarkeit eine wichtige Rolle spielen. Schneller Zugriff auf häufig genutzte Daten Red Hat Data Grid ist für Unternehmen interessant, die ihre Anwendungen durch einen leistungsfähigen In-Memory-Datenansatz unterstützen möchten. Häufig abgefragte Daten können in geeigneten Szenarien schneller bereitgestellt werden, sodass Anwendungen reaktionsschneller arbeiten und Benutzeranfragen effizienter verarbeitet werden können. Gerade bei geschäftskritischen Anwendungen kann ein strukturierter Datenzugriff entscheidend sein. Wenn Systeme regelmäßig auf Datenbanken, Webservices oder andere Backend-Quellen zugreifen müssen, kann ein Data-Grid-Ansatz helfen, wiederkehrende Zugriffe besser zu organisieren. Unternehmen erhalten dadurch eine bessere Grundlage, um Performance-Anforderungen kontrollierter zu planen und bestehende Anwendungen gezielt zu unterstützen. Verteilte Datenhaltung für moderne Enterprise-Architekturen Red Hat Data Grid unterstützt verteilte Datenstrukturen und kann in passenden Umgebungen dazu beitragen, Daten über mehrere Knoten hinweg bereitzustellen. Dadurch eignet sich die Lösung für Unternehmen, die skalierbare Anwendungen betreiben und Datenzugriffe nicht nur lokal, sondern über moderne Plattform- und Cluster-Architekturen hinweg organisieren möchten. In wachsenden IT-Landschaften ist es wichtig, Datenzugriffe nachvollziehbar und flexibel zu gestalten. Anwendungen, Services und Plattformen müssen oft schnell auf Informationen zugreifen können, ohne dass zentrale Backend-Systeme unnötig belastet werden. Red Hat Data Grid bietet hierfür eine professionelle Grundlage, um Datenzugriffe, Caching-Strategien und verteilte Anwendungsprozesse besser miteinander zu verbinden. Für Anwendungen, Plattformen und hybride Umgebungen Red Hat Data Grid kann in unterschiedlichen Unternehmensumgebungen relevant sein. Dazu gehören klassische Java-Anwendungen, moderne Plattformarchitekturen, containerisierte Workloads oder hybride IT-Landschaften. Die genaue technische Umsetzung hängt vom jeweiligen Red Hat Subskriptionsmodell, der vorhandenen Infrastruktur und dem geplanten Einsatzbereich ab. Besonders in Verbindung mit Red Hat OpenShift und modernen Plattformstrategien kann Data Grid eine wichtige Rolle spielen, wenn Anwendungen performante Datenzugriffe benötigen. Unternehmen können damit eine zusätzliche Ebene für schnelle Datenbereitstellung, Caching und verteilte Datenprozesse einplanen, ohne ihre gesamte Anwendungsarchitektur sofort grundlegend verändern zu müssen. Mehr Struktur für Performance- und Caching-Szenarien Red Hat Data Grid eignet sich für Szenarien, in denen Daten häufig genutzt, schnell abgefragt oder über mehrere Anwendungsteile hinweg verfügbar gemacht werden sollen. Unternehmen können damit eine strukturierte Grundlage schaffen, um Caching-Strategien, Datenzugriffe und Performance-Anforderungen besser zu planen. In-Memory-Datenzugriff: Geeignet für Anwendungen, die häufig benötigte Daten besonders schnell abrufen sollen. Verteilte Datenstrukturen: Unterstützt Szenarien, in denen Daten über mehrere Knoten oder Plattformbereiche hinweg organisiert werden müssen. Performance-Optimierung: Eine passende Grundlage, um Anwendungen mit hohen Anforderungen an Reaktionszeit und Datenzugriff besser zu unterstützen. Enterprise-Integration: Kann in bestehende Anwendungs-, Middleware- und Plattformstrategien eingeordnet werden. Geeignet für datenintensive Unternehmensanwendungen Red Hat Data Grid ist besonders interessant für Unternehmen, die geschä...31114,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data GridRed Hat Data Grid – In-Memory-Datenspeicher für schnelle und skalierbare Anwendungen Red Hat Data Grid ist eine professionelle Red Hat Subskriptionslösung für Unternehmen, die Daten schneller bereitstellen, Anwendungen performanter machen und verteilte Datenzugriffe strukturierter organisieren möchten. Die Lösung eignet sich besonders für moderne Unternehmensanwendungen, bei denen häufig genutzte Daten mit möglichst geringer Latenz verfügbar sein sollen. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Subskription für den vorgesehenen Nutzungsumfang. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, OpenShift, Linux, Integration oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der gewünschten Laufzeit und dem konkreten Einsatzszenario. Die Lösung richtet sich an IT-Abteilungen, Entwicklungsteams, Plattformverantwortliche und Unternehmen, die datenintensive Anwendungen zuverlässiger und reaktionsschneller betreiben möchten. Red Hat Data Grid kann dabei helfen, häufig benötigte Daten näher an Anwendungen bereitzustellen und damit Zugriffe auf langsamere Backend-Systeme zu reduzieren. Dadurch eignet sich die Lösung für Szenarien, in denen Performance, Skalierbarkeit und Datenverfügbarkeit eine wichtige Rolle spielen. Schneller Zugriff auf häufig genutzte Daten Red Hat Data Grid ist für Unternehmen interessant, die ihre Anwendungen durch einen leistungsfähigen In-Memory-Datenansatz unterstützen möchten. Häufig abgefragte Daten können in geeigneten Szenarien schneller bereitgestellt werden, sodass Anwendungen reaktionsschneller arbeiten und Benutzeranfragen effizienter verarbeitet werden können. Gerade bei geschäftskritischen Anwendungen kann ein strukturierter Datenzugriff entscheidend sein. Wenn Systeme regelmäßig auf Datenbanken, Webservices oder andere Backend-Quellen zugreifen müssen, kann ein Data-Grid-Ansatz helfen, wiederkehrende Zugriffe besser zu organisieren. Unternehmen erhalten dadurch eine bessere Grundlage, um Performance-Anforderungen kontrollierter zu planen und bestehende Anwendungen gezielt zu unterstützen. Verteilte Datenhaltung für moderne Enterprise-Architekturen Red Hat Data Grid unterstützt verteilte Datenstrukturen und kann in passenden Umgebungen dazu beitragen, Daten über mehrere Knoten hinweg bereitzustellen. Dadurch eignet sich die Lösung für Unternehmen, die skalierbare Anwendungen betreiben und Datenzugriffe nicht nur lokal, sondern über moderne Plattform- und Cluster-Architekturen hinweg organisieren möchten. In wachsenden IT-Landschaften ist es wichtig, Datenzugriffe nachvollziehbar und flexibel zu gestalten. Anwendungen, Services und Plattformen müssen oft schnell auf Informationen zugreifen können, ohne dass zentrale Backend-Systeme unnötig belastet werden. Red Hat Data Grid bietet hierfür eine professionelle Grundlage, um Datenzugriffe, Caching-Strategien und verteilte Anwendungsprozesse besser miteinander zu verbinden. Für Anwendungen, Plattformen und hybride Umgebungen Red Hat Data Grid kann in unterschiedlichen Unternehmensumgebungen relevant sein. Dazu gehören klassische Java-Anwendungen, moderne Plattformarchitekturen, containerisierte Workloads oder hybride IT-Landschaften. Die genaue technische Umsetzung hängt vom jeweiligen Red Hat Subskriptionsmodell, der vorhandenen Infrastruktur und dem geplanten Einsatzbereich ab. Besonders in Verbindung mit Red Hat OpenShift und modernen Plattformstrategien kann Data Grid eine wichtige Rolle spielen, wenn Anwendungen performante Datenzugriffe benötigen. Unternehmen können damit eine zusätzliche Ebene für schnelle Datenbereitstellung, Caching und verteilte Datenprozesse einplanen, ohne ihre gesamte Anwendungsarchitektur sofort grundlegend verändern zu müssen. Mehr Struktur für Performance- und Caching-Szenarien Red Hat Data Grid eignet sich für Szenarien, in denen Daten häufig genutzt, schnell abgefragt oder über mehrere Anwendungsteile hinweg verfügbar gemacht werden sollen. Unternehmen können damit eine strukturierte Grundlage schaffen, um Caching-Strategien, Datenzugriffe und Performance-Anforderungen besser zu planen. In-Memory-Datenzugriff: Geeignet für Anwendungen, die häufig benötigte Daten besonders schnell abrufen sollen. Verteilte Datenstrukturen: Unterstützt Szenarien, in denen Daten über mehrere Knoten oder Plattformbereiche hinweg organisiert werden müssen. Performance-Optimierung: Eine passende Grundlage, um Anwendungen mit hohen Anforderungen an Reaktionszeit und Datenzugriff besser zu unterstützen. Enterprise-Integration: Kann in bestehende Anwendungs-, Middleware- und Plattformstrategien eingeordnet werden. Geeignet für datenintensive Unternehmensanwendungen Red Hat Data Grid ist besonders interessant für Unternehmen, die geschä...8643,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was passiert, wenn ich bei Spotify auf "Daten löschen" bzw. "Clear Data" gehe?
Wenn du bei Spotify auf "Daten löschen" oder "Clear Data" gehst, werden alle lokal gespeicherten Daten auf deinem Gerät gelöscht. Das beinhaltet heruntergeladene Songs, Playlists und Einstellungen. Du musst dich anschließend erneut bei Spotify anmelden und deine gewünschten Einstellungen und Songs erneut herunterladen. **
-
Wie kann Data Visualization dabei helfen, komplexe Daten auf verständliche Weise zu präsentieren?
Data Visualization kann komplexe Daten visuell darstellen, um Muster und Trends leichter erkennbar zu machen. Durch die Verwendung von Diagrammen, Grafiken und interaktiven Visualisierungen können Informationen schnell und effektiv vermittelt werden. Dies erleichtert die Entscheidungsfindung und ermöglicht es, komplexe Zusammenhänge auf einen Blick zu erfassen. **
-
Sind "data" und "data" beim USB-Kabel TX und RX?
Nein, "data" und "data" beziehen sich nicht auf die TX (Transmit) und RX (Receive) Pins beim USB-Kabel. Beim USB-Kabel gibt es vier Pins: VCC (Stromversorgung), GND (Masse), D+ (Datenleitung) und D- (Datenleitung). Die TX- und RX-Pins werden normalerweise bei seriellen Kommunikationsschnittstellen wie UART verwendet. **
-
Kann man mit Wirtschaftsinformatik Data Scientist oder Data Analyst werden?
Ja, mit einem Studium der Wirtschaftsinformatik kann man sowohl Data Scientist als auch Data Analyst werden. Wirtschaftsinformatik vermittelt Kenntnisse in den Bereichen Informatik und Betriebswirtschaft, die für diese Berufe relevant sind. Zusätzliche Weiterbildungen oder Spezialisierungen in den Bereichen Data Science oder Data Analytics können jedoch von Vorteil sein. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.